实例介绍
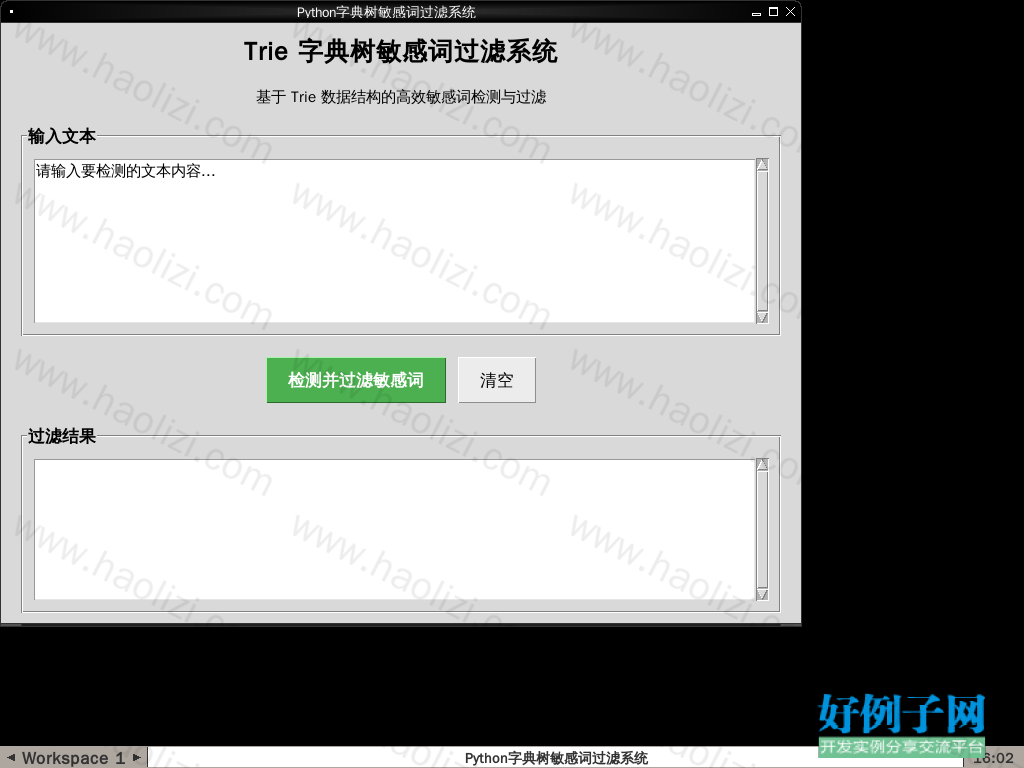
🖥️ 运行效果
🚀 实例简介
本实例实现了基于 Trie(字典树)数据结构的敏感词过滤系统。Trie 是一种高效的字符串检索树,特别适合多模式匹配场景。本工具可以在文本中快速检测和替换敏感词,适用于内容审核、评论过滤等场景。
💻 核心代码
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Python字典树(Trie)实现敏感词过滤系统
功能:使用 Trie 数据结构高效检测和过滤敏感词
作者:好例子网 (haolizi.com)
"""

import tkinter as tk
from tkinter import ttk, scrolledtext
import platform

# 中文字体配置
CHINESE_FONT = "WenQuanYi Zen Hei" if platform.system() == "Linux" else "Microsoft YaHei"


class TrieNode:
    """Trie 树节点"""
    def __init__(self):
        self.children = {}
        self.is_end = False


class Trie:
    """Trie 字典树实现"""
    def __init__(self):
        self.root = TrieNode()

    def insert(self, word):
        """插入敏感词到 Trie"""
        node = self.root
        for char in word:
            if char not in node.children:
                node.children[char] = TrieNode()
            node = node.children[char]
        node.is_end = True

    def search(self, text):
        """在文本中查找敏感词,返回 (位置, 长度) 列表"""
        results = []
        for i in range(len(text)):
            node = self.root
            j = i
            while j < len(text) and text[j] in node.children:
                node = node.children[text[j]]
                if node.is_end:
                    results.append((i, j - i   1))
                j  = 1
        return results


class SensitiveWordFilter:
    """敏感词过滤器"""
    def __init__(self):
        self.trie = Trie()
        # 内置敏感词库
        self.sensitive_words = [
            "暴力", "赌博", "毒品", "枪支", "诈骗",
            "色情", "反动", "传销", "假币", "洗钱"
        ]
        self.load_words()

    def load_words(self):
        """加载敏感词到 Trie"""
        for word in self.sensitive_words:
            self.trie.insert(word)

    def filter_text(self, text, replace_char="*"):
        """过滤文本中的敏感词"""
        matches = self.trie.search(text)
        if not matches:
            return text, []

        # 按位置排序,从后往前替换避免索引错乱
        matches.sort(reverse=True)
        filtered = text
        found_words = []

        for pos, length in matches:
            word = text[pos:pos length]
💡 适用场景
办公自动化、数据分析、快速原型开发
好例子网口号:伸出你的我的手 — 分享!
相关软件
小贴士
感谢您为本站写下的评论,您的评论对其它用户来说具有重要的参考价值,所以请认真填写。
- 类似“顶”、“沙发”之类没有营养的文字,对勤劳贡献的楼主来说是令人沮丧的反馈信息。
- 相信您也不想看到一排文字/表情墙,所以请不要反馈意义不大的重复字符,也请尽量不要纯表情的回复。
- 提问之前请再仔细看一遍楼主的说明,或许是您遗漏了。
- 请勿到处挖坑绊人、招贴广告。既占空间让人厌烦,又没人会搭理,于人于己都无利。
关于好例子网
本站旨在为广大IT学习爱好者提供一个非营利性互相学习交流分享平台。本站所有资源都可以被免费获取学习研究。本站资源来自网友分享,对搜索内容的合法性不具有预见性、识别性、控制性,仅供学习研究,请务必在下载后24小时内给予删除,不得用于其他任何用途,否则后果自负。基于互联网的特殊性,平台无法对用户传输的作品、信息、内容的权属或合法性、安全性、合规性、真实性、科学性、完整权、有效性等进行实质审查;无论平台是否已进行审查,用户均应自行承担因其传输的作品、信息、内容而可能或已经产生的侵权或权属纠纷等法律责任。本站所有资源不代表本站的观点或立场,基于网友分享,根据中国法律《信息网络传播权保护条例》第二十二与二十三条之规定,若资源存在侵权或相关问题请联系本站客服人员,点此联系我们。关于更多版权及免责申明参见 版权及免责申明
网友评论
我要评论