实例介绍
🖥️ 运行效果
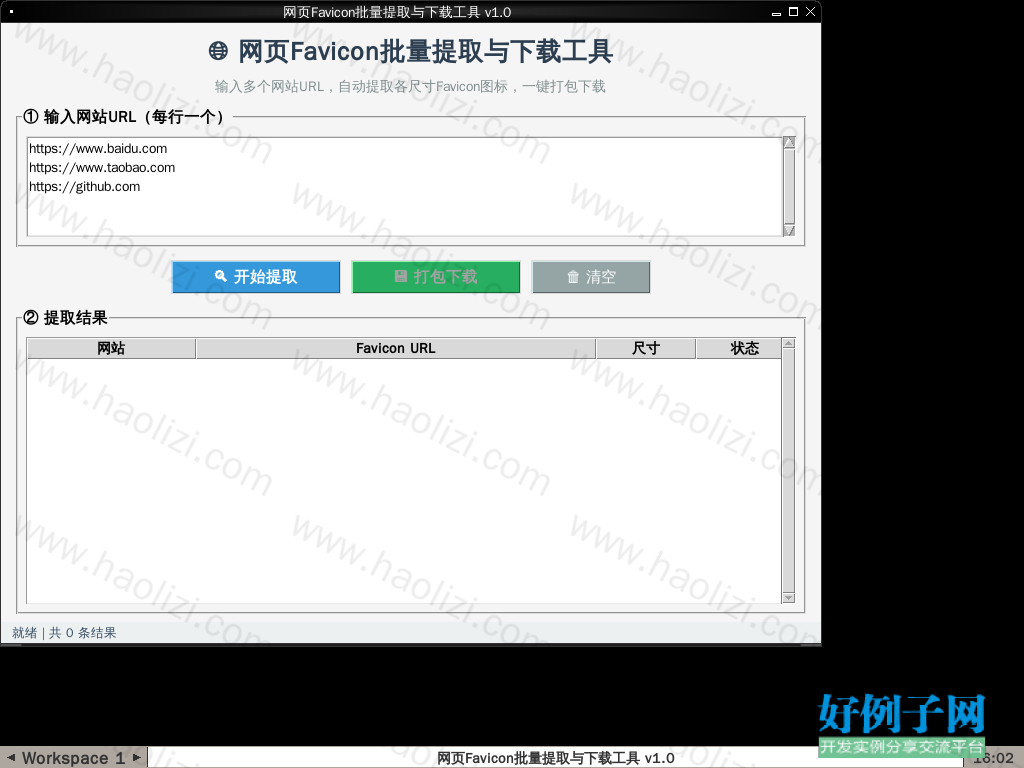
🚀 实例简介
一款基于 Python + Tkinter 开发的桌面 GUI 工具,可批量提取多个网站的 Favicon 图标。支持自动解析 HTML 中的 link 标签、检测默认 /favicon.ico,并将所有图标打包为 ZIP 下载。适用于 Web 开发者、SEO 人员、设计师批量收集网站图标素材。
💻 核心代码
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
网页Favicon批量提取与下载工具
功能:输入多个网站URL,自动提取各尺寸Favicon,支持ICO/PNG格式,一键打包下载
作者:51Python
"""
import tkinter as tk
from tkinter import ttk, filedialog, messagebox, scrolledtext
import threading
import requests
import os
import zipfile
import re
from urllib.parse import urlparse, urljoin
from html.parser import HTMLParser

# 中文字体配置(无头环境必须用元组形式,禁用 option_add)
import platform
CHINESE_FONT = "WenQuanYi Zen Hei" if platform.system() == "Linux" else "Microsoft YaHei"


class FaviconParser(HTMLParser):
    """解析HTML中的favicon链接"""
    def __init__(self):
        super().__init__()
        self.favicons = []

    def handle_starttag(self, tag, attrs):
        if tag == "link":
            attr_dict = dict(attrs)
            rel = attr_dict.get("rel", "").lower()
            href = attr_dict.get("href", "")
            if "icon" in rel and href:
                self.favicons.append({
                    "rel": rel,
                    "href": href,
                    "sizes": attr_dict.get("sizes", "any")
                })


def extract_favicons(url, timeout=8):
    """从指定URL提取所有favicon链接"""
    results = []
    if not url.startswith("http"):
        url = "https://" + url
    try:
        resp = requests.get(url, timeout=timeout, headers={
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
        })
        resp.raise_for_status()
        # 解析HTML中的favicon
        parser = FaviconParser()
        try:
            parser.feed(resp.text[:50000])
        except Exception:
            pass
        for f in parser.favicons:
            full_url = urljoin(url, f["href"])
            results.append({"url": full_url, "sizes": f["sizes"], "source": "html"})
        # 默认 /favicon.ico
        parsed = urlparse(url)
        default_ico = f"{parsed.scheme}://{parsed.netloc}/favicon.ico"
        if not any(r["url"] == default_ico for r in results):
            results.insert(0, {"url": default_ico, "sizes": "any", "source": "default"})
    except Exception as e:
        results.append({"url": "", "sizes": "", "source": "error", "error": str(e)})
    return results


def download_favicon(url, save_path, timeout=10):
    """下载favicon到指定路径"""
    try:
        resp = requests.get(url, timeout=timeout, headers={
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"
        }, stream=True)
        resp.raise_for_status()
        with open(save_path, "wb") as f:
            for chunk in resp.iter_content(8192):
                f.write(chunk)
💡 适用场景
办公自动化、数据分析、快速原型开发
标签:
好例子网口号:伸出你的我的手 — 分享!
相关软件
- Linux文件权限可视化计算器与chmod命令生成器:rwx权限位二进制可视化、数字/符号模式双向转换、特殊权限SUID/SGID/Sticky Bit说明、批量chmod命令生成、一键复制执行
- 文件批量备份与恢复工具(增量备份+AES加密+版本管理+一键回滚)
- Python桌面版Webhook测试接收器与调试工具:本地启动HTTP服务接收回调请求、实时显示请求头与Body、历史记录持久化、一键导出JSON
- Python桌面版HTTP接口断言测试工具:可视化定义测试用例、自动发送请求、校验状态码与JSON字段、批量执行生成测试报告
- Python桌面版HTTP状态码速查与学习工具:1xx-5xx全分类展示、详细说明与使用场景、关键词搜索过滤、收藏常用状态码、一键复制说明
相关文章
- Excel工作表批量重命名与顺序调整工具:一键导入多Sheet文件、自由调整顺序、批量添加前后缀、预览变更一键导出
- 二维码批量生成与识别工具:支持文本/URL/WiFi/名片多种格式、CSV导入批量导出PNG、图片二维码扫描解码、一键导出
- Docker Compose配置文件可视化生成器:多服务编排、端口映射、数据卷挂载图形化配置、环境变量管理、语法校验、一键导出docker-compose.yml
- 网页HTML/CSS/JS代码压缩美化工具:支持三种语言一键切换、自定义压缩选项(移除注释/空白/换行)、实时预览对比、压缩率统计、一键复制导出
- 图片批量压缩与WebP转换工具:自定义质量/尺寸、多格式支持(JPG/PNG/WebP)、体积对比统计、一键导出
小贴士
感谢您为本站写下的评论,您的评论对其它用户来说具有重要的参考价值,所以请认真填写。
- 类似“顶”、“沙发”之类没有营养的文字,对勤劳贡献的楼主来说是令人沮丧的反馈信息。
- 相信您也不想看到一排文字/表情墙,所以请不要反馈意义不大的重复字符,也请尽量不要纯表情的回复。
- 提问之前请再仔细看一遍楼主的说明,或许是您遗漏了。
- 请勿到处挖坑绊人、招贴广告。既占空间让人厌烦,又没人会搭理,于人于己都无利。
关于好例子网
本站旨在为广大IT学习爱好者提供一个非营利性互相学习交流分享平台。本站所有资源都可以被免费获取学习研究。本站资源来自网友分享,对搜索内容的合法性不具有预见性、识别性、控制性,仅供学习研究,请务必在下载后24小时内给予删除,不得用于其他任何用途,否则后果自负。基于互联网的特殊性,平台无法对用户传输的作品、信息、内容的权属或合法性、安全性、合规性、真实性、科学性、完整权、有效性等进行实质审查;无论平台是否已进行审查,用户均应自行承担因其传输的作品、信息、内容而可能或已经产生的侵权或权属纠纷等法律责任。本站所有资源不代表本站的观点或立场,基于网友分享,根据中国法律《信息网络传播权保护条例》第二十二与二十三条之规定,若资源存在侵权或相关问题请联系本站客服人员,点此联系我们。关于更多版权及免责申明参见 版权及免责申明
网友评论
我要评论