实例介绍
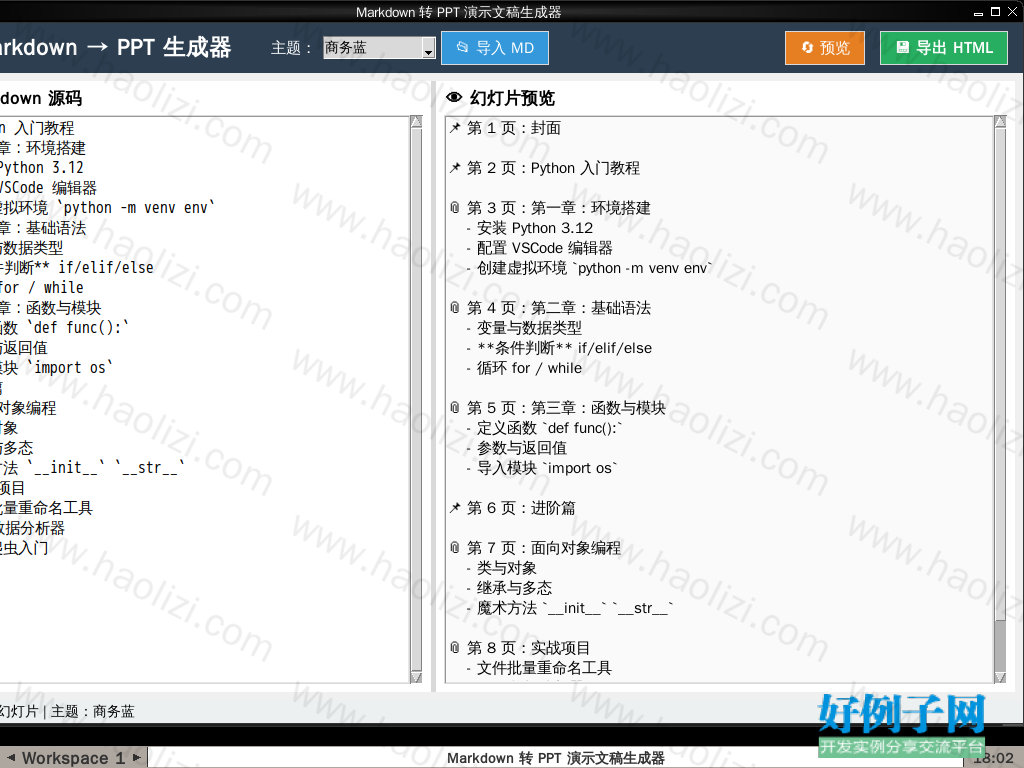
🖥️ 运行效果
🚀 实例简介
一款基于 Python + Tkinter 的桌面工具,可将 Markdown 文本快速转换为精美的 HTML 演示文稿。支持 5 种主题配色(商务蓝/极简白/暗夜黑/森林绿/暖阳橙)、实时预览、键盘翻页(←/→/空格),一键导出独立 HTML 文件,用浏览器打开即可全屏演示。零第三方依赖,纯标准库实现。
💻 核心代码
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Markdown 转 PPT 演示文稿生成器
解析 Markdown 标题层级自动生成幻灯片,支持主题切换,一键导出 HTML 演示文件。
"""
import tkinter as tk
from tkinter import ttk, filedialog, messagebox, scrolledtext
import re, os, platform, datetime
CHINESE_FONT = "WenQuanYi Zen Hei" if platform.system() == "Linux" else "Microsoft YaHei"
# 主题配色方案
THEMES = {
"商务蓝": {"bg": "#1e3a5f", "fg": "#ffffff", "accent": "#4a90e2", "code_bg": "#0d1b2a"},
"极简白": {"bg": "#ffffff", "fg": "#2c3e50", "accent": "#3498db", "code_bg": "#f5f6fa"},
"暗夜黑": {"bg": "#1a1a2e", "fg": "#eaeaea", "accent": "#e94560", "code_bg": "#0f0f1e"},
"森林绿": {"bg": "#1b4332", "fg": "#f1faee", "accent": "#95d5b2", "code_bg": "#081c15"},
"暖阳橙": {"bg": "#fff3e0", "fg": "#3e2723", "accent": "#ff6f00", "code_bg": "#ffe0b2"},
}
def parse_markdown(text: str) -> list:
"""解析 Markdown 文本,按 H1/H2 切分为幻灯片列表"""
slides = []
current = {"title": "封面", "level": 1, "body": []}
for line in text.splitlines():
m = re.match(r'^(#{1,3})\s+(.*)', line)
if m:
if current["title"] or current["body"]:
slides.append(current)
level = len(m.group(1))
current = {"title": m.group(2).strip(), "level": level, "body": []}
else:
stripped = line.rstrip()
if stripped or current["body"]:
current["body"].append(stripped)
if current["title"] or current["body"]:
slides.append(current)
return slides or [{"title": "空白演示", "level": 1, "body": ["(请在左侧输入 Markdown 内容)"]}]
def render_html(slides: list, theme: dict, title: str) -> str:
"""将幻灯片列表渲染为全屏 HTML 演示文稿"""
slides_html = []
for i, s in enumerate(slides, 1):
body_html = "
".join(
re.sub(r'\*\*(.+?)\*\*', r'\1',
re.sub(r'`(.+?)`', r'\1', line))
for line in s["body"] if line.strip()
)
font_size = {1: "48px", 2: "36px", 3: "28px"}.get(s["level"], "32px")
slides_html.append(
f''
)
return f'''
{title}
{"".join(slides_html)}
相关软件
- Linux文件权限可视化计算器与chmod命令生成器:rwx权限位二进制可视化、数字/符号模式双向转换、特殊权限SUID/SGID/Sticky Bit说明、批量chmod命令生成、一键复制执行
- 文件批量备份与恢复工具(增量备份+AES加密+版本管理+一键回滚)
- Python桌面版Webhook测试接收器与调试工具:本地启动HTTP服务接收回调请求、实时显示请求头与Body、历史记录持久化、一键导出JSON
- Python桌面版HTTP接口断言测试工具:可视化定义测试用例、自动发送请求、校验状态码与JSON字段、批量执行生成测试报告
- Python桌面版HTTP状态码速查与学习工具:1xx-5xx全分类展示、详细说明与使用场景、关键词搜索过滤、收藏常用状态码、一键复制说明
相关文章
- Excel工作表批量重命名与顺序调整工具:一键导入多Sheet文件、自由调整顺序、批量添加前后缀、预览变更一键导出
- 二维码批量生成与识别工具:支持文本/URL/WiFi/名片多种格式、CSV导入批量导出PNG、图片二维码扫描解码、一键导出
- Docker Compose配置文件可视化生成器:多服务编排、端口映射、数据卷挂载图形化配置、环境变量管理、语法校验、一键导出docker-compose.yml
- 网页HTML/CSS/JS代码压缩美化工具:支持三种语言一键切换、自定义压缩选项(移除注释/空白/换行)、实时预览对比、压缩率统计、一键复制导出
- 图片批量压缩与WebP转换工具:自定义质量/尺寸、多格式支持(JPG/PNG/WebP)、体积对比统计、一键导出
小贴士
感谢您为本站写下的评论,您的评论对其它用户来说具有重要的参考价值,所以请认真填写。
- 类似“顶”、“沙发”之类没有营养的文字,对勤劳贡献的楼主来说是令人沮丧的反馈信息。
- 相信您也不想看到一排文字/表情墙,所以请不要反馈意义不大的重复字符,也请尽量不要纯表情的回复。
- 提问之前请再仔细看一遍楼主的说明,或许是您遗漏了。
- 请勿到处挖坑绊人、招贴广告。既占空间让人厌烦,又没人会搭理,于人于己都无利。
关于好例子网
本站旨在为广大IT学习爱好者提供一个非营利性互相学习交流分享平台。本站所有资源都可以被免费获取学习研究。本站资源来自网友分享,对搜索内容的合法性不具有预见性、识别性、控制性,仅供学习研究,请务必在下载后24小时内给予删除,不得用于其他任何用途,否则后果自负。基于互联网的特殊性,平台无法对用户传输的作品、信息、内容的权属或合法性、安全性、合规性、真实性、科学性、完整权、有效性等进行实质审查;无论平台是否已进行审查,用户均应自行承担因其传输的作品、信息、内容而可能或已经产生的侵权或权属纠纷等法律责任。本站所有资源不代表本站的观点或立场,基于网友分享,根据中国法律《信息网络传播权保护条例》第二十二与二十三条之规定,若资源存在侵权或相关问题请联系本站客服人员,点此联系我们。关于更多版权及免责申明参见 版权及免责申明
网友评论
我要评论